Agora sim, agora estamos quase alcançando o nosso objetivo. Nosso relatório para a equipe de vendas da classificação dos clientes da Alura Voz, em Churn “sim” e “não”, aqueles clientes que, sim, saíram da empresa e os, não, não saíram da empresa e ainda continuam, está quase pronto.
Passamos por toda uma etapa na coleta dos dados, fizemos o tratamento, balanceamento, recebemos novas informações, as informações da Maria que ainda não temos o Churn e, claro, entendemos melhor como funciona a classificação, o que é classificação e quais algoritmos podemos utilizar de Machine Learning.
Entre eles, nós testamos três modelos: o modelo KNN, o modelo Bernoulli Naive Bayes e o modelo árvore de decisão. Agora é aquele momento de validar a performance desses modelos. Vamos ver o quão bom estão e qual é o melhor para nós mostrarmos para a equipe de vendas. A primeira métrica que eu apresento a você é a matriz de confusão. A matriz de confusão é basicamente uma tabela contendo quatro formas de visualizar os resultados.
Como assim, Ana? Vamos entender melhor. Vamos lá. Pegue o seu papel, pegue o seu lápis, pegue sua caneta e vamos escrever à mão a nossa tabela. Começamos aqui. Primeira coluna, temos o "SIM". Segunda coluna, o "NÃO". Primeira linha, "SIM", segunda linha, "NÃO". As colunas representam os resultados preditos e as linhas representam os valores reais, aqueles que realmente são. Como funciona a matriz de confusão, quais são as visões que ela traz? Ela traz os nossos resultados.

Vamos começar aqui na primeira coluna e na primeira linha. Temos o "SIM", foi predito um valor "SIM" e o valor real realmente era "SIM". Qual é o resultado disso? É um verdadeiro positivo, é um verdadeiro sim. Temos o Churn, a Maria foi classificada como "SIM". Estava lá que realmente é um "SIM". Esse é o verdadeiro positivo, são os resultados verdadeiramente corretos, como "SIM". Agora vamos para a segunda visão dos nossos resultados.
Vamos para a segunda coluna, primeira linha. Temos o predito como o valor "NÃO", porém, o real é o "SIM". Esse resultado é conhecido como falso negativo ou um falso não, ele deveria ser predito como "SIM", mas ele foi predito como "NÃO". É um valor incorreto da nossa classificação, são aqueles resultados errôneos. Agora podemos passar para a segunda linha. Vamos lá. Primeira coluna, segunda linha. Foi um predito que o valor é um "SIM", contudo, o verdadeiro valor é um "NÃO".
O que isso quer dizer? Isso quer dizer que o Churn foi previsto como "SIM", só que o valor dele real é "NÃO". Temos um resultado falso positivo, ou seja, um falso sim, aquele Churn que foi visto como "SIM", mas, na verdade, ele é um "NÃO". São os resultados também errados, são os resultados errôneos da nossa classificação. Agora segunda coluna, segunda linha. Temos o predito como "NÃO" e o real como "NÃO".
São aqueles valores que são os verdadeiros negativos, são os valores realmente preditos com "NÃO" e são realmente "NÃO". Foi um Churn previsto como "NÃO" e ele realmente é um "NÃO". Outro valor previsto de forma correta. Nossos valores verdadeiros, positivo e verdadeiro negativo são os valores previstos de forma correta no nosso modelo. Agora entendemos como que é estruturada a matriz de confusão, como ela funciona.
Ela aparente ser bem simples, mas é muito importante e de extrema atenção entendê-la e saber como ela funciona, porque a partir da matriz de confusão outras métricas e performance dos modelos são extraídas. Vamos começar. Sabemos o que é matriz de confusão, agora como que nós extraímos essa matriz de confusão dos nossos modelos? Vamos primeiro chamar a biblioteca SKLearn e o pacote confusion matrix.
Vamos lá então.
from sklearn.metrics import confusion_matrix

Rodamos a célula. Perfeito. Funções todas carregadas, agora vamos aplicar nos nossos modelos. Eu vou mandar imprimir aqui na nossa tela a matriz de confusão primeiro do nosso modelo KNN. Vamos lá.
print(confusion_matrix(y_teste, predito_knn))
O primeiro valor na nossa aplicação da função confusion_matrix é o valor que realmente é, o valor real, o nosso y_teste.
O primeiro valor na nossa aplicação da função confusion_matrix é o valor que realmente é, o valor real, o nosso y_teste.

Lembra quando dividimos os nossos dados? Nós sabemos que esse y_teste sabemos o Churn dele. E o predito_knn, que é o segundo valor da função, é o valor predito pelo nosso modelo. Vamos rodar e aqui está. Ele imprime bonito na nossa tela uma matriz de confusão. Vamos recapitular? A primeira coluna, primeira linha, verdadeiro positivo, tivemos 1241 valores verdadeiros positivos. Interessante, é um resultado alto, muito bom.
Agora segunda coluna, primeira linha, são os falsos negativos, tivemos 328 no modelo KNN. Interessante. Atenção aos números. Agora primeira coluna, segunda linha, falsos positivos, tivemos no modelo KNN 247. Comparado aos acertos ainda é um valor relativamente baixo. Agora os verdadeiros negativos, segunda coluna, segunda linha, 1289. Outro valor bem alto, muito interessante.
Tenha em mente esses resultados e essa matriz para as próximas métricas. Agora vamos ver na matriz de confusão no modelo Bernoulli. Novamente,
print(confusion_matrix(y_teste, predito_Bnb))
, que é do nosso modelo Bernoulli. Vamos lá. Aqui está nosso resultado. Novamente uma matriz, vamos verificar os verdadeiros positivos. Verdadeiros positivos 1050, os falsos negativos 519, os falsos positivos 242 e os verdadeiros negativos 1294.

Já comparando as matrizes de confusão, se verificarmos aqui os falsos negativos e os falsos positivos, os valores estão maiores nos falsos negativos do que o KNN, mas os falsos positivos não, são menores. Está bem alto essa diferença. Atenção, talvez o modelo KNN esteja indo melhor, vamos ver. Agora vamos ver a matriz de confusão da árvore de decisão. A mesma coisa do que foi feito anteriormente.
Aqui está. Interessante. Temos verdadeiros positivos 1249 no nosso modelo. Está maior que o do KNN e do modelo de Bernoulli Naive Bayes. Interessante.
print(confusion_matrix(y_teste, predito_ArvoreDecisao))
Agora os falsos negativos, 320. Está menor que o KNN e menor do que o Bernoulli. Atenção. Agora os falsos positivos, olha que interessante. Apesar dos outros terem sido maiores, maior e menor caso, aqui os falsos positivos foi maior que os outros dois modelos. Árvore de decisão tem uma dificuldade maior para classificar os positivos. Interessante.
Agora os falsos negativos, 320. Está menor que o KNN e menor do que o Bernoulli. Atenção. Agora os falsos positivos, olha que interessante. Apesar dos outros terem sido maiores, maior e menor caso, aqui os falsos positivos foi maior que os outros dois modelos. Árvore de decisão tem uma dificuldade maior para classificar os positivos. Interessante.

Aqui 1259 são os nossos verdadeiros negativos e também é o menos de todos os modelos. Também é um ponto de atenção. Como ele é o menor pode ser que nossa árvore também tenha dificuldade em classificar os "NÃOs" do nosso Churn. Interessante.
Temos esses valores em mãos, sabemos como funciona a matriz de confusão, vamos para a primeira métrica.
O que é a Matriz de confusão?
A matriz de confusão é uma ferramenta muito utilizada para avaliar modelos de machine learning de classificação. Ela consiste em uma matriz em que as linhas representam os valores reais e as colunas representam os valores preditos. Cada espaço da matriz passa a ser um diagnóstico. A ideia geral é contabilizar a quantidade de vezes que um determinado valor A é classificado como valor B.
Para trabalharmos com um exemplo, vamos pensar em uma lista de possíveis clientes da Alura Voz, na qual você executou um modelo de predição e obteve a seguinte classificação:valores_preditos = [0, 1, 1, 1, 0, 0, 1, 0, 0, 1]COPIAR CÓDIGO
Os valores reais da classificação dessas pessoas são:valores_verdadeiros= [0, 1, 0, 1, 0, 0, 1, 0, 1, 0]COPIAR CÓDIGO
Nele, o valor 0 significa que o(a) cliente possivelmente não irá assinar o plano da Alura Voz e 1 significa que poderá assinar.
Analisando apenas os valores de valores_preditos e valores_verdadeiros, percebe-se que o modelo errou na classificação de algumas amostras. A matriz de confusão nos mostrará a frequência de classificação para cada classe em nosso modelo da seguinte forma:
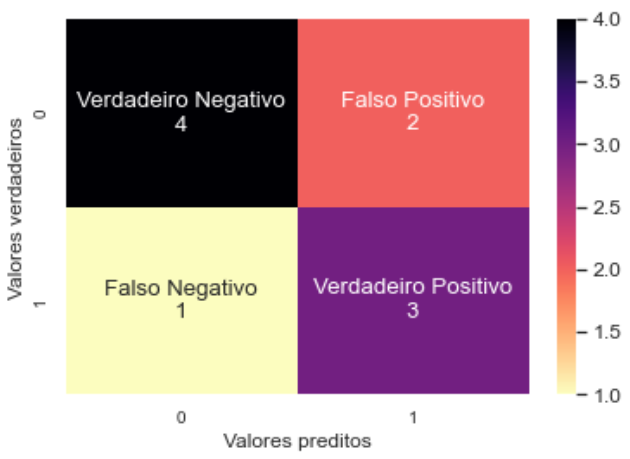
Na primeira linha e primeira coluna estão 4 valores verdadeiros negativos, ou seja, o modelo previu a classe como negativa (no nosso exemplo a classe negativa é 0) e isso realmente é verdade. Já na primeira linha e segunda coluna foram classificados 2 valores como 1, porém seu valor real é 0. Como o modelo classificou a classe positiva como sendo negativa, chamamos de falso positivo.
Seguindo para a segunda linha e primeira coluna, temos que o modelo classificou 1 valor como pertencendo à classe 0, porém seu valor real é 1. Logo, o modelo previu a classe negativa, mas isso é falso e chamamos de falso negativo. Por último, na segunda linha e segunda coluna, 3 valores foram classificados como 1, o que realmente é verdade de acordo com o valor real. Logo, foi prevista a classe verdadeira e ela é conhecida como verdadeiro positivo.
Uma observação importante: a matriz de confusão pode se apresentar também na ordem inversa à mostrada aqui, com as linhas sendo os valores preditos pelo modelo e as colunas como os valores reais. Assim, é importante não decorar a ordem, mas realizar a análise feita anteriormente. Dessa forma, você não irá cometer erros.
Para saber como a matriz acima foi criada, você pode acessar o seguinte repositório no GitHub: Gerando matriz de confusão


Nenhum comentário:
Postar um comentário