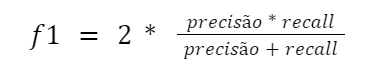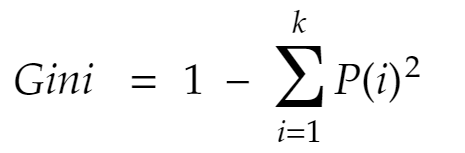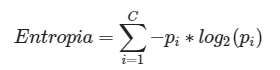terça-feira, 30 de janeiro de 2024

Por que escolher Spring como seu framework Java?


1. Visão Geral


Neste artigo, examinaremos a principal proposta de valor do Spring como um dos frameworks Java mais populares.
Mais importante ainda, tentaremos entender as razões do Spring ser nossa estrutura preferida. Detalhes do Spring e suas partes constituintes foram amplamente abordados em nossos tutoriais anteriores . Portanto, pularemos as partes introdutórias do “como” e nos concentraremos principalmente nos “porquês”.

2. Por que usar um framework?


Antes de começarmos qualquer discussão em particular sobre o Spring, vamos primeiro entender por que precisamos usar um framework.
Uma linguagem de programação de uso geral como Java é capaz de suportar uma ampla variedade de aplicações. Sem mencionar que o Java está sendo trabalhado ativamente e melhorando a cada dia.
Além disso, existem inúmeras bibliotecas proprietárias e open-source para oferecer suporte ao Java nesse sentido.
Então, por que precisamos de um framework, afinal? Honestamente, não é absolutamente necessário usar um framework para realizar uma tarefa. Mas muitas vezes é aconselhável usar um por vários motivos:
  • Nos ajuda a focar na tarefa principal, e não no padrão associado a ela
  • Reúne anos de sabedoria na forma de padrões de design
  • Nos ajuda a aderir aos padrões regulatórios e tanto do java quando de padrões de internet
  • Reduz o custo total de propriedade do aplicativo

Acabamos de falar apenas superficialmente aqui e devemos dizer que os benefícios são difíceis de ignorar. Mas nem tudo pode ser positivo, então qual é o problema:
  • Nos obriga a escrever um aplicativo de uma maneira específica
  • Deixa travado a uma versão específica de linguagem e bibliotecas (lock-in)
  • Aumenta a pegada de recursos do aplicativo (componentes, bibliotecas e outras coisas que acabam indo na mochila)
Francamente, não existem soluções mágicas no desenvolvimento de software e os frameworks certamente não são exceção a isso. Portanto, a escolha de qual framework ou nenhum deve ser determinada pelo contexto.
Espero que estaremos em melhor posição para tomar essa decisão em relação ao Spring até o final deste artigo.

3. Breve Visão Geral do Ecossistema Primavera


Antes de começarmos nossa avaliação qualitativa do Spring Framework, vamos dar uma olhada mais de perto em como é o ecossistema Spring.
O Spring surgiu em 2003, numa época em que o Java Enterprise Edition estava evoluindo rapidamente e o desenvolvimento de um aplicativo corporativo era empolgante, mas ainda assim tedioso!
O Spring começou como um contêiner de Inversão de Controle (IoC) para Java. Ainda relacionamos o Spring principalmente com ele e, na verdade, ele constitui o núcleo do framework e de outros projetos que foram desenvolvidos em cima dele.

3.1. Estrutura Primavera

O framework Spring é dividido em módulos, o que torna muito fácil escolher as partes para usar em qualquer aplicação:
  • Core : Fornece recursos básicos como DI (Injeção de Dependência), Internacionalização, Validação e AOP (Programação Orientada a Aspectos)
  • Data Access : suporta acesso a dados por meio de JTA (Java Transaction API), JPA (Java Persistence API) e JDBC (Java Database Connectivity)
  • Web : Suporta API Servlet ( Spring MVC ) e recentemente Reactive API ( Spring WebFlux ) e, adicionalmente, suporta WebSockets, STOMP e WebClient
  • Integration : Suporta integração com Enterprise Java por meio de JMS (Java Message Service), JMX (Java Management Extension) e RMI (Remote Method Invocation)
  • Testing : amplo suporte para testes unitários e de integração por meio de objetos simulados, acessórios de teste, gerenciamento de contexto e cache

3.2. Projetos do Spring

Mas o que torna o Spring muito mais valioso é um ecossistema forte que cresceu em torno dele ao longo dos anos e que continua a evoluir ativamente . Eles são estruturados como projetos Spring que são desenvolvidos com base na estrutura do Spring.

Embora a lista de projetos Spring seja longa e esteja sempre mudando, há alguns que vale a pena mencionar:

  • Boot : nos fornece um conjunto de modelos altamente opinativos, mas extensíveis, para criar vários projetos baseados no Spring em quase nenhum momento. Isso torna muito fácil criar aplicativos Spring independentes com Tomcat incorporado ou um contêiner semelhante.
  • Cloud : fornece suporte para desenvolver facilmente alguns dos padrões comuns de sistemas distribuídos, como descoberta de serviço, disjuntor e gateway de API. Isso nos ajuda a reduzir o esforço para implantar esses padrões padronizados em plataformas locais, remotas ou mesmo gerenciadas.
  • Security : Fornece um mecanismo robusto para desenvolver autenticação e autorização para projetos baseados em Spring de maneira altamente customizável. Com suporte declarativo mínimo, obtemos proteção contra ataques comuns, como fixação de sessão, click-jacking e falsificação de solicitação entre sites.
  • Mobile : fornece recursos para detectar o dispositivo e adaptar o comportamento do aplicativo de acordo. Além disso, oferece suporte ao gerenciamento de visualização com reconhecimento de dispositivo para uma experiência de usuário ideal, gerenciamento de preferências de site e alternador de site.
  • Batch : fornece uma estrutura leve para o desenvolvimento de aplicativos em lote para sistemas corporativos, como arquivamento de dados. Possui suporte intuitivo para scheduling, reinicialização, skipping, coleta de métricas e logging. Além disso, oferece suporte à expansão para trabalhos de alto volume por meio de otimização e particionamento.
Não preciso dizer que esta é uma introdução bastante abstrata ao que o Spring tem a oferecer. Mas fornece-nos terreno suficiente no que diz respeito à organização e amplitude do Spring para levar a nossa discussão mais longe.

4. O Spring em ação


É comum adicionar um programa hello-world para entender qualquer nova tecnologia.
Vamos ver como o Spring pode tornar fácil escrever um programa que faça mais do que apenas hello-world . Criaremos um aplicativo que vai expor as operações CRUD como APIs REST para uma entidade de domínio como Employee, apoiada por um banco de dados na memória. Além do mais, protegeremos nossos endpoints de mutação usando autenticação básica. Finalmente, nenhum aplicativo pode realmente ser completo sem o bom e velho teste unitário.

4.1. Configuração do projeto


Configuraremos nosso projeto Spring Boot usando Spring Initializr , que é uma ferramenta online conveniente para inicializar projetos com as dependências corretas. Adicionaremos Web, JPA, H2 e security como dependências do projeto para obter a configuração do Maven corretamente.
Mais detalhes sobre bootstrapping estão disponíveis em um de nossos artigos anteriores.

4.2. Modelo de Domínio e Persistência


Com tão pouco a ser feito, já estamos prontos para definir nosso modelo de domínio e persistência.
 Vamos primeiro definir o Funcionário como uma entidade JPA simples:


@Entity
public class Employee { @Id @GeneratedValue(strategy = GenerationType.AUTO) private Long id; @NotNull private String firstName; @NotNull private String lastName; // Standard constructor, getters and setters }

Observe o ID gerado automaticamente que incluímos em nossa definição de entidade.


Agora temos que definir um repositório JPA para nossa entidade. É aqui que o Spring torna tudo realmente simples:


public
interface EmployeeRepository extends CrudRepository<Employee, Long> { List<Employee> findAll(); }

Tudo o que precisamos fazer é definir uma interface como esta, e o Spring JPA nos fornecerá uma implementação desenvolvida com operações padrão e personalizadas . Muito legal! Encontre mais detalhes sobre como trabalhar com Spring Data JPA em nossos outros artigos.

4.3. O Controller


Agora temos que definir um controlador web para rotear e tratar nossas solicitações recebidas:

@RestController public class EmployeeController { @Autowired private EmployeeRepository repository; @GetMapping("/employees") public List<Employee> getEmployees() { return repository.findAll(); } // Other CRUD endpoints handlers }

Na verdade, tudo o que tivemos que fazer foi anotar a classe e definir meta-informações de roteamento junto com cada método manipulador.

4.4. Security


Já definimos tudo, mas e quanto à segurança de operações como criar ou excluir funcionários? Não queremos acesso não autenticado a esses terminais!

Spring Security realmente brilha nesta área:

@EnableWebSecurity
public class WebSecurityConfig {
 
    @Bean
    public SecurityFilterChain filterChain(HttpSecurity http) throws Exception {
        http
          .authorizeRequests()
            .antMatchers(HttpMethod.GET, "/employees", "/employees/**")
            .permitAll()
          .anyRequest()
            .authenticated()
          .and()
            .httpBasic();
        return http.build();
    }
    // other necessary beans and definitions
}

Há mais detalhes aqui que requerem atenção para serem entendidos, mas o ponto mais importante a ser observado é a maneira declarativa pela qual permitimos apenas operações GET irrestritas.


4.5. Testing


Agora já fizemos tudo, mas espere, como testamos isso?

Vamos ver se o Spring pode facilitar a escrita de testes unitários para controllers REST:

@RunWith(SpringRunner.class) @SpringBootTest(webEnvironment = WebEnvironment.RANDOM_PORT) @AutoConfigureMockMvc public class EmployeeControllerTests { @Autowired private MockMvc mvc; @Test @WithMockUser() public void givenNoEmployee_whenCreateEmployee_thenEmployeeCreated() throws Exception { mvc.perform(post("/employees").content( new ObjectMapper().writeValueAsString(new Employee("First", "Last")) .with(csrf())) .contentType(MediaType.APPLICATION_JSON) .accept(MediaType.APPLICATION_JSON)) .andExpect(MockMvcResultMatchers.status() .isCreated()) .andExpect(jsonPath("$.firstName", is("First"))) .andExpect(jsonPath("$.lastName", is("Last"))); } // other tests as necessary }

Como podemos ver, o Spring nos fornece um framework básico  para escrever testes simples de unidade e integração que, de outra forma, dependem do contexto do Spring para serem inicializados e configurados.


4.6. Rodando a aplicação


Finalmente, como executamos este aplicativo? Este é outro aspecto interessante do Spring Boot. Embora possamos empacotar isso como um aplicativo normal e implantar tradicionalmente em um contêiner Servlet.
Mas qual a graça de fazer dessa forma? O Spring Boot vem com um servidor Tomcat incorporado :

@SpringBootApplication public class Application { public static void main(String[] args) { SpringApplication.run(Application.class, args); } }

Esta é uma classe que vem pré-criada como parte do bootstrap e possui todos os detalhes necessários para iniciar esta aplicação utilizando o servidor embarcado.
Além disso, isso é altamente personalizável .

5. Alternativas ao Spring


Embora escolher usar uma estrutura seja relativamente mais fácil, escolher entre estruturas muitas vezes pode ser assustador com as escolhas que temos. Mas para isso, devemos ter pelo menos uma compreensão aproximada de quais alternativas existem para os recursos que o Spring tem a oferecer.
Como discutimos anteriormente, a estrutura Spring, juntamente com seus projetos, oferece uma ampla escolha para um desenvolvedor corporativo escolher . Se fizermos uma avaliação rápida dos frameworks Java contemporâneos, eles não chegam nem perto do ecossistema que o Spring nos fornece.

No entanto, para áreas específicas, constituem um argumento convincente para escolher como alternativas:

  • Guice : oferece um contêiner IoC robusto para aplicativos Java
  • Play : se encaixa perfeitamente como uma estrutura da Web com suporte reativo
  • Hibernate : Uma estrutura estabelecida para acesso a dados com suporte JPA
Além destas, existem algumas adições recentes que oferecem suporte mais amplo do que um domínio específico, mas ainda não cobrem tudo o que o Spring tem a oferecer:

  • Micronaut : uma estrutura baseada em JVM adaptada para microsserviços nativos da nuvem
  • Quarkus : uma pilha Java da nova era que promete oferecer tempo de inicialização mais rápido e ocupar menos espaço
Obviamente, não é necessário nem viável entrar em detalhes em cada item da lista, mas temos uma ideia geral aqui.

6. Então, por que escolher o Spring?

Finalmente, construímos todo o contexto necessário para abordar a nossa questão central, porquê o Spring? Compreendemos como uma estrutura pode nos ajudar no desenvolvimento de aplicativos empresariais complexos.
Além disso, entendemos as opções que temos para preocupações específicas como web, acesso a dados, integração em termos de framework, especialmente para Java.
Agora, onde brilha o Spring entre tudo isto? Vamos explorar.

6.1. Usabilidade

Um dos principais aspectos da popularidade de qualquer framework é a facilidade de uso dos desenvolvedores. O Spring através de múltiplas opções de configuração e Convenção sobre Configuração torna muito fácil para os desenvolvedores iniciarem e configurarem exatamente o que precisam.
Projetos como o Spring Boot tornaram o a configuração inicial de um projeto complexo do Spring quase que trivial. Sem falar que possui excelente documentação e tutoriais para ajudar qualquer pessoa a iniciar.

6.2. Modularidade

Outro aspecto importante da popularidade do Spring é sua natureza altamente modular. Temos opções para usar todo o framework Spring ou apenas os módulos necessários. Além disso, podemos opcionalmente incluir um ou mais projetos Spring dependendo da necessidade.
Além do mais, temos a opção de usar outros frameworks como Hibernate ou Struts também!

6.3. Conformidade

Embora o Spring não suporte todas as especificações do Jakarta EE, ele suporta todas as suas tecnologias , muitas vezes melhorando o suporte em relação à especificação padrão quando necessário. Por exemplo, Spring oferece suporte a repositórios baseados em JPA e, portanto, torna trivial a troca de provedor.
Além disso, o Spring oferece suporte a especificações do setor, como Reactive Stream no Spring Web Reactive e HATEOAS no Spring HATEOAS.

6.4. Testabilidade

A adoção de qualquer estrutura também depende em grande parte da facilidade de testar o aplicativo construído sobre ela. Spring at the core defende e apoia o Desenvolvimento Orientado a Testes (TDD).
Uma aplicação Spring é composta principalmente de POJOs, o que naturalmente torna o teste de unidade relativamente mais simples. No entanto, o Spring fornece Mocks para cenários como MVC, onde o teste de unidade fica complicado.

6.5. A Maturidade

O Spring tem uma longa história de inovação, adoção e padronização. Com o passar dos anos, ele amadureceu o suficiente para se tornar uma solução padrão para a maioria dos problemas comuns enfrentados no desenvolvimento de aplicativos empresariais em larga escala.
O que é ainda mais desafiador é o quão ativamente ele está sendo desenvolvido e mantido. O suporte para novos recursos de linguagem e soluções de integração empresarial são desenvolvidos todos os dias.

6.6. Suporte da comunidade

Por último, mas não menos importante, qualquer estrutura ou mesmo biblioteca sobrevive à indústria através da inovação e não há lugar melhor para a inovação do que a comunidade. Spring é um código aberto liderado pela Pivotal Software e apoiado por um grande consórcio de organizações e desenvolvedores individuais.
Isto significa que permanece contextual e muitas vezes futurista, como é evidente pelo número de projetos de baixo do seu guarda-chuva.

7. Razões para não usar o Spring


Há uma grande variedade de aplicativos que podem se beneficiar de um nível diferente de uso do Spring, e isso está mudando tão rápido quanto o Spring cresce.
No entanto, devemos entender que o Spring, como qualquer outro framework, é útil no gerenciamento da complexidade do desenvolvimento de aplicações. Isso nos ajuda a evitar armadilhas comuns e mantém o aplicativo passível de manutenção à medida que cresce com o tempo.\
Isso entra como um custo de se preocupar com a manutenção e evolução do framework e uma curva de aprendizado do spring, por menor que seja. Se realmente existe um aplicativo que é simples o suficiente e não se espera que se torne complexo, talvez seja mais benéfico não usar nenhum framework!

8. Conclusão

Neste artigo, discutimos os benefícios de usar um framework no desenvolvimento de aplicativos. Discutimos brevemente o Spring Framework em particular.
Ainda no assunto, também examinamos alguns dos frameworks alternativos disponíveis para Java.
Por fim, discutimos os motivos que podem nos levar a escolher Spring como framework preferido para Java.
Devemos terminar este artigo com um conselho. Por mais atraente que possa parecer, geralmente não existe uma solução única e que sirva para todos no desenvolvimento de software.
Portanto, devemos aplicar nosso conhecimento na escolha das soluções mais simples para os problemas específicos que pretendemos resolver.


Este post foi escrito pelo blog https://www.baeldung.com/ e adaptado para Português por Fabio Pereira, arquiteto sênior de soluções.

link do artigo : https://www.baeldung.com/spring-why-to-choose


sábado, 27 de janeiro de 2024

Tipo de métricas: Recall e F1 Score


A última métrica que eu apresento a você é o recall. O recall também é conhecido como revocação ou sensibilidade. Preste muita atenção, o recall muitas vezes é confundido com a precisão, porque ele vai medir quão bom o nosso modelo está em classificar os resultados realmente positivos.


Vamos ver a fórmula do recall. Verdadeiros positivos, que são aqueles que foram classificados como sim pelo nosso modelo e que são realmente sim, divididos pelos verdadeiros positivos mais os falsos negativos, "RC = TP/TP + FN". Entendeu a diferença?

Aqui, os falsos negativos não deveriam ser positivos? Por isso que essa métrica é considerada aquela que calcula realmente quais os resultados verdadeiramente positivos. Vamos aplicar no nosso modelo e ver qual o resultado disso.

Novamente vamos chamar a biblioteca metrics e agora o recall_store, 

from sklearn.metrics import recall_score

. Funções carregadas no notebook, vamos aplicar o nosso primeiro modelo o KNN:

 print(recall_score(y_teste, predito_knn))

, tendo um resultado de 0,8391 ou em porcentagem 83,91%. É um valor muito alto, muito bom e quanto maior quer dizer que melhor está o modelo em classificar esses valores como sim, o nosso Churn sim.

Vamos agora para o modelo Bernoulli de Naive Bayes. A mesma coisa, 

print(recall_score(y_teste, predito_BNb))

. Já o nosso modelo de Bernoulli foi melhor, ele teve 84,24% de acertos. O nosso modelo está bom em acerta os sins.

Lembrando, que o nosso Churn igual a sim é aquele cliente que realmente saiu da empresa, ele saiu, não faz mais parte, não tem mais contrato ativo, saiu da Alura Voz.

Vamos agora para o modelo final, a árvore de decisão. A mesma coisa dos outros modelos, alterando somente para o predito_ArvoreDecisao. 

print(recall_score(y_teste, predito_ArvoreDecisao))

, tendo o resultado de 81,96%.

 Olha que curioso, cada uma das métricas que apresentei para você mostrou que um modelo era melhor do que o outro. Tivemos a acurácia que trouxe o KNN como melhor modelo, tivemos a precisão que trouxe o modelo de árvore de decisão como melhor. E agora, na recall, na sensibilidade o melhor modelo é o Bernoulli de Naive Bayes.


F1 Score

Além da acurácia, precisão e recall, podemos extrair da matriz de confusão uma outra métrica conhecida como f1 score, que é uma média harmônica entre o recall e a precisão.O recall e a precisão são grandezas inversamente proporcionais, ou seja, à medida que vai aumentando o recall, por consequência irá diminuir a precisão e vice-versa.

O f1 score é uma métrica para identificar se algum dos valores de recall ou precisão estão baixos, uma vez que não é muito interessante ter um modelo com um alto recall e pouca precisão, ou vice versa. Então, caso sua intenção seja obter um valor equilibrado entre o recall e a precisão, a métrica que precisamos maximizar é o f1 score.

Para calcular, devemos utilizar a fórmula:


Curva ROC e AUC

Existe ainda uma métrica conhecida como AUC (Area Under the Curve), ou área sob a curva, que pode ser extraída da curva ROC. Essa métrica tem valor máximo de 1 e quanto maior o número mais bem avaliado será o modelo de classificação. Para a construção da curva ROC, precisamos utilizar diferentes pontos de corte para avaliação do modelo de classificação.

É possível criar diferentes matrizes de confusão a partir dos diversos pontos de corte e extrair as métricas de recall (taxa de verdadeiros positivos) e taxa de falsos positivos. Sendo esta última, o valor de falsos positivos dividido pela soma de todos os valores negativos reais. Essas métricas podem ser sumarizadas em uma tabela e serão as coordenadas da curva ROC. Vamos entender como funcionam esses pontos de corte.

Na construção de um modelo de classificação, a predição de uma classe está atrelada a uma probabilidade. Imagine que temos uma variável alvo com duas possibilidades (0 ou 1). Se um modelo classifica uma observação como 1, significa que há uma probabilidade de x% de que aquela observação seja da classe 1.

O ponto de corte é um valor de probabilidade no qual, se a probabilidade de predição for maior que esse valor, atribui-se a observação à classe 1. Se for menor, atribui-se a observação à classe 0. À medida que o ponto de corte varia, os resultados obtidos na classificação se tornam diferentes, fazendo com que o modelo acerte mais de uma classe em troca de errar mais em outra.

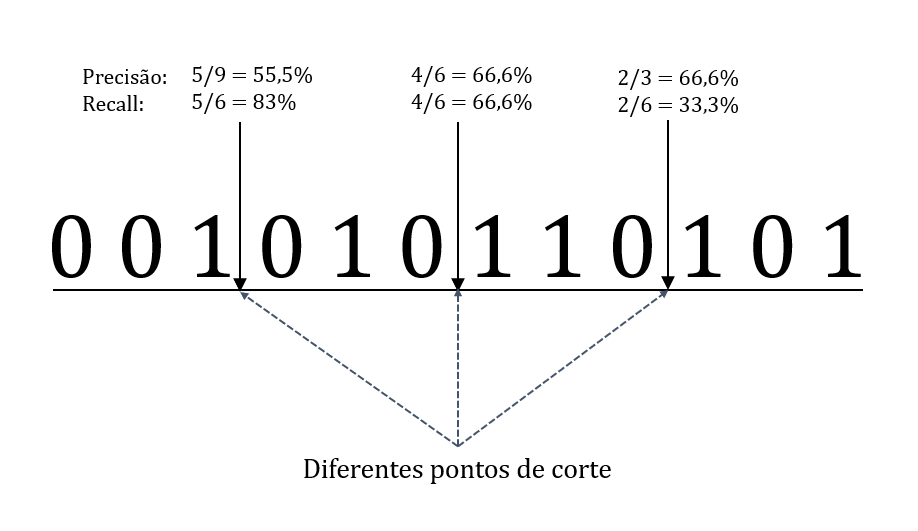
Através de um exemplo, ficará evidente como os pontos de corte modificam as métricas da matriz de confusão. Na imagem abaixo estão representados a precisão e o recall. Nela estão definidos 3 pontos de corte em 25%, 50% e 75%, representados pelas setas verticais. Os zeros e uns são os valores reais das classes e a classificação será feita através dos pontos de corte. Os valores à esquerda da seta serão classificados como 0 e os valores à direita serão classificados como 1 pelo modelo.


No primeiro ponto de corte temos 3 valores classificados como 0, à esquerda; e 9 valores como 1, à direita. A precisão é dada por 5/(5+4) = 55,5%, mostrando que 5 valores foram classificados corretamente como 1, dentre 9 valores totais classificados como 1. O recall é dado por 5/(5+1) = 83%, indicando que 5 valores foram classificados corretamente como 1, dentre 6 valores reais 1 no conjunto de dados.

No segundo ponto de corte temos 6 valores classificados como 0 à esquerda; e 6 valores classificados como 1, à direita. A precisão é dada por 4/(4+2) = 66,6%, apontando que 4 valores foram classificados corretamente como 1, dentre 6 valores totais classificados como 1. O recall é dado por 4/(4+2) = 66,6%, demonstrando que 4 valores foram classificados corretamente como 1, dentre 6 valores reais 1 no conjunto de dados. O mesmo raciocínio pode ser aplicado para o último ponto de corte, resultando em valores diferentes para as métricas.

Para cada ponto de corte, uma matriz de confusão pode ser criada e as métricas podem ser extraídas em uma tabela, na qual cada linha representa um ponto de corte com suas respectivas métricas. Desta tabela, pode ser construído o gráfico da curva ROC. Esta curva mostra como o classificador se comporta para diferentes valores de pontos de corte, de acordo com a relação de verdadeiros positivos e falsos positivos.


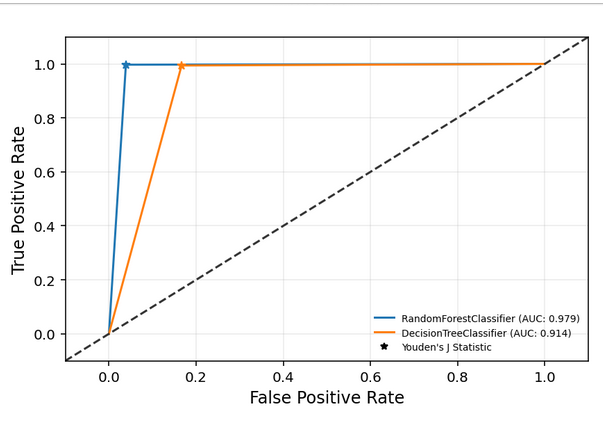
Existe uma linha de referência na diagonal do gráfico que corresponde à uma linha de base e representa o caso no qual o classificador identifica aleatoriamente as classes. Mas como podemos interpretar esse gráfico?

Percebemos que a linha representando o classificador RandomForestClassifier cresce rapidamente até atingir o valor máximo de True Positive Rate (o recall). Isso significa que o modelo atinge 100% de classificação correta dos positivos e permanece até atingir o ponto (1, 1) do gráfico. Esse ponto nos diz que o modelo tem 100% de True Positive Rate e 100% de False Positive Rate (taxa de falso negativos), indicando que ele classifica todas as amostras positivas corretamente e todas as amostras que não são positivas foram incorretamente classificadas.

Então, quando o modelo chega no 100% de True Positive Rate e lá permanece até atingir o 100% do False Positive Rate, ele consegue classificar todas as amostras positivas de forma correta independentemente do threshold adotado. Por outro lado, a linha representando o classificador DecisionTreeClassifier demora mais para chegar no 100% de True Positive Rate. Porém, quando chega no valor máximo, permanece igual à do classificador anterior.

Esse pequeno atraso do DecisionTreeClassifier em relação ao RandomForestClassifier resulta em áreas diferentes, que são as AUCs para cada classificador. O primeiro teve uma AUC de 0.914 e o segundo 0.979. Portanto, esse último é o melhor classificador.

Tipos de Metrica: precisão


A próxima métrica que eu apresento a você é a Precisão. A Precisão calcula quantos verdadeiros positivos foram classificados de forma correta, foram preditos de forma correta. Como se calcula isso?


Sabemos que os verdadeiros positivos são aqueles que foram realmente preditos como verdadeiro sim, a precisão é calculada da seguinte forma: o total de verdadeiros positivos dividido pelos verdadeiros positivos mais os falsos positivos, "PS = TP/TP + FP".

Estamos pegando os verdadeiros positivos e dividindo pelo total de positivos previstos, seja ele correto ou não. Essa é a precisão, cálculo dos positivos corretos.

Vamos implementar essa métrica para aplicar aos dados. Novamente, vamos chamar a biblioteca SKLearn e o pacote metrics e agora vamos chamar a função precision_score e chamamos da mesma forma que as outras bibliotecas: 

from sklearn.metrics import precision_score.

Funções também importadas, tudo carregado no nosso notebook, vamos agora mandar ver nossas precisões de cada um dos modelos.

O primeiro modelo é o KNN: 

print(precision_score(y_teste, predito_knn))

. Da mesma forma das outras métricas, quais dados aplicamos na função o primeiro é o real e o segundo dado é o predito, classificado pelo nosso modelo.

Vamos ver os nossos resultados e aqui está, para o modelo KNN temos uma precisão de 0,07971, em porcentagem 79,71%. Parece que a precisão dos positivos está menor que a acurácia.

Agora vamos verificar o modelo de Bernoulli de Naive Bayes. Novamente, vamos mandar imprimir o nosso score da precisão, 

print(precision_score(y_teste, predito_BNb))

. Vamos ver, a precisão do modelo de Bernoulli também deu 71,37%.

Vamos ver a árvore de decisão. Até agora o modelo KNN é o mais preciso em relação aos positivos. O modelo da árvore de decisão é 79,73%. No caso de escolhermos a métrica de precisão para mostrar para a equipe de vendas, o modelo da árvore de decisão seria o melhor modelo a se apresentar como o relatório, como resultado da classificação.

Olha que curioso, cada uma das métricas apresentaram um modelo como melhor. A acurácia apresentou o KNN, a precisão apresentou o modelo árvore de decisão. Atenção à isso, lembre-se disso.


Vamos ver a próxima métrica.

Tipos de Metrica : Acuracia - o quanto a gente acertou


A primeira métrica que eu apresento a você extraída da matriz de confusão é a acurácia. No nosso modelo a acurácia mede o quanto o nosso modelo acertou do total, do total de resultados o quanto que ela acertou.

 Temos a seguinte conta: a acurácia vai ser igual aos verdadeiros positivos mais os verdadeiros negativos. Você lembra da matriz de confusão? São os valores realmente corretos, os verdadeiros sins e os verdadeiros nãos no nosso Churn. Dividido por todos os resultados, os verdadeiros positivos mais os falsos positivos, mais os verdadeiros negativos mais os falsos negativos, resultando no total de valores inferidos de forma correta, classificados previstos de forma correta, "ACC = TP + TN/TP + FP + TN + FN".


 Para fazer o cálculo da acurácia vamos chamar o pacote métrico da biblioteca SKLearn e a função accuracy. from sklearn,metrics import accuracy_score. Vamos rodar e ok, as funções estão carregadas. Vamos ver a acurácia do nosso primeiro modelo, o quanto o nosso modelo realmente previu certo, classificou certo no total de resultados. Em todos os valores classificados o quanto ele realmente acertou.

print(accuracy_score(y_teste, predito_knn)), o primeiro modelo é o KNN. Novamente, os primeiros dados a serem colocados na função da acurácia, do score da acurácia é o conjunto Y teste, é o valor real. E o segundo valor é o predito pelo nosso modelo.

 Vamos verificar e obtivemos um resultado de 0.8148, se multiplicarmos por 100 temos 81,48% de acerto. É um valor alto, muito interessante.

 Vamos ver os outros modelos, qual entre eles está acertando mais. Agora o Bernoulli, da mesma forma que o modelo KNN vamos mandar imprimir: print(accuracy_score(y_teste, predito_bnb)), vamos verificar. O modelo Bernoulli teve um resultado de acurácia de 0,7549. Novamente, 75,49%, o modelo KNN até agora está ganhando.

Se considerarmos a métrica da acurácia o modelo que apresentaríamos para a equipe de vendas seria o modelo KNN. Agora vamos verificar a árvore de decisão, a mesma coisa que os outros modelos, a única coisa que vamos alterar é o modelo, vamos colocar predito_ArvoreDecisao. Vamos mandar imprimir.

 O resultado do nosso modelo da árvore de decisão é de 80,77%. Se considerarmos o quanto o nossos modelos acertaram o melhor modelo para classificar os verdadeiros positivos e os verdadeiros negativos é o KNN. 81,48% e é esse modelo que apresentaríamos para a equipe de vendas.


 Quais são as outras métricas?

Matriz de confusão


 Agora sim, agora estamos quase alcançando o nosso objetivo. Nosso relatório para a equipe de vendas da classificação dos clientes da Alura Voz, em Churn “sim” e “não”, aqueles clientes que, sim, saíram da empresa e os, não, não saíram da empresa e ainda continuam, está quase pronto.

Passamos por toda uma etapa na coleta dos dados, fizemos o tratamento, balanceamento, recebemos novas informações, as informações da Maria que ainda não temos o Churn e, claro, entendemos melhor como funciona a classificação, o que é classificação e quais algoritmos podemos utilizar de Machine Learning.

 Entre eles, nós testamos três modelos: o modelo KNN, o modelo Bernoulli Naive Bayes e o modelo árvore de decisão. Agora é aquele momento de validar a performance desses modelos. Vamos ver o quão bom estão e qual é o melhor para nós mostrarmos para a equipe de vendas. A primeira métrica que eu apresento a você é a matriz de confusão. A matriz de confusão é basicamente uma tabela contendo quatro formas de visualizar os resultados.

Como assim, Ana? Vamos entender melhor. Vamos lá. Pegue o seu papel, pegue o seu lápis, pegue sua caneta e vamos escrever à mão a nossa tabela. Começamos aqui. Primeira coluna, temos o "SIM". Segunda coluna, o "NÃO". Primeira linha, "SIM", segunda linha, "NÃO". As colunas representam os resultados preditos e as linhas representam os valores reais, aqueles que realmente são. Como funciona a matriz de confusão, quais são as visões que ela traz? Ela traz os nossos resultados.


Vamos começar aqui na primeira coluna e na primeira linha. Temos o "SIM", foi predito um valor "SIM" e o valor real realmente era "SIM". Qual é o resultado disso? É um verdadeiro positivo, é um verdadeiro sim. Temos o Churn, a Maria foi classificada como "SIM". Estava lá que realmente é um "SIM". Esse é o verdadeiro positivo, são os resultados verdadeiramente corretos, como "SIM". Agora vamos para a segunda visão dos nossos resultados.

Vamos para a segunda coluna, primeira linha. Temos o predito como o valor "NÃO", porém, o real é o "SIM". Esse resultado é conhecido como falso negativo ou um falso não, ele deveria ser predito como "SIM", mas ele foi predito como "NÃO". É um valor incorreto da nossa classificação, são aqueles resultados errôneos. Agora podemos passar para a segunda linha. Vamos lá. Primeira coluna, segunda linha. Foi um predito que o valor é um "SIM", contudo, o verdadeiro valor é um "NÃO".

O que isso quer dizer? Isso quer dizer que o Churn foi previsto como "SIM", só que o valor dele real é "NÃO". Temos um resultado falso positivo, ou seja, um falso sim, aquele Churn que foi visto como "SIM", mas, na verdade, ele é um "NÃO". São os resultados também errados, são os resultados errôneos da nossa classificação. Agora segunda coluna, segunda linha. Temos o predito como "NÃO" e o real como "NÃO".

São aqueles valores que são os verdadeiros negativos, são os valores realmente preditos com "NÃO" e são realmente "NÃO". Foi um Churn previsto como "NÃO" e ele realmente é um "NÃO". Outro valor previsto de forma correta. Nossos valores verdadeiros, positivo e verdadeiro negativo são os valores previstos de forma correta no nosso modelo. Agora entendemos como que é estruturada a matriz de confusão, como ela funciona.

Ela aparente ser bem simples, mas é muito importante e de extrema atenção entendê-la e saber como ela funciona, porque a partir da matriz de confusão outras métricas e performance dos modelos são extraídas. Vamos começar. Sabemos o que é matriz de confusão, agora como que nós extraímos essa matriz de confusão dos nossos modelos? Vamos primeiro chamar a biblioteca SKLearn e o pacote confusion matrix.

Vamos lá então.

from sklearn.metrics import confusion_matrix 


Rodamos a célula. Perfeito. Funções todas carregadas, agora vamos aplicar nos nossos modelos. Eu vou mandar imprimir aqui na nossa tela a matriz de confusão primeiro do nosso modelo KNN. Vamos lá.

print(confusion_matrix(y_teste, predito_knn))


O primeiro valor na nossa aplicação da função confusion_matrix é o valor que realmente é, o valor real, o nosso y_teste.


Lembra quando dividimos os nossos dados? Nós sabemos que esse y_teste sabemos o Churn dele. E o predito_knn, que é o segundo valor da função, é o valor predito pelo nosso modelo. Vamos rodar e aqui está. Ele imprime bonito na nossa tela uma matriz de confusão. Vamos recapitular? A primeira coluna, primeira linha, verdadeiro positivo, tivemos 1241 valores verdadeiros positivos. Interessante, é um resultado alto, muito bom.

Agora segunda coluna, primeira linha, são os falsos negativos, tivemos 328 no modelo KNN. Interessante. Atenção aos números. Agora primeira coluna, segunda linha, falsos positivos, tivemos no modelo KNN 247. Comparado aos acertos ainda é um valor relativamente baixo. Agora os verdadeiros negativos, segunda coluna, segunda linha, 1289. Outro valor bem alto, muito interessante.

Tenha em mente esses resultados e essa matriz para as próximas métricas. Agora vamos ver na matriz de confusão no modelo Bernoulli. Novamente, 

print(confusion_matrix(y_teste, predito_Bnb))

, que é do nosso modelo Bernoulli. Vamos lá. Aqui está nosso resultado. Novamente uma matriz, vamos verificar os verdadeiros positivos. Verdadeiros positivos 1050, os falsos negativos 519, os falsos positivos 242 e os verdadeiros negativos 1294.


Já comparando as matrizes de confusão, se verificarmos aqui os falsos negativos e os falsos positivos, os valores estão maiores nos falsos negativos do que o KNN, mas os falsos positivos não, são menores. Está bem alto essa diferença. Atenção, talvez o modelo KNN esteja indo melhor, vamos ver. Agora vamos ver a matriz de confusão da árvore de decisão. A mesma coisa do que foi feito anteriormente.

Aqui está. Interessante. Temos verdadeiros positivos 1249 no nosso modelo. Está maior que o do KNN e do modelo de Bernoulli Naive Bayes. Interessante.

print(confusion_matrix(y_teste, predito_ArvoreDecisao)) 


Agora os falsos negativos, 320. Está menor que o KNN e menor do que o Bernoulli. Atenção. Agora os falsos positivos, olha que interessante. Apesar dos outros terem sido maiores, maior e menor caso, aqui os falsos positivos foi maior que os outros dois modelos. Árvore de decisão tem uma dificuldade maior para classificar os positivos. Interessante.


Aqui 1259 são os nossos verdadeiros negativos e também é o menos de todos os modelos. Também é um ponto de atenção. Como ele é o menor pode ser que nossa árvore também tenha dificuldade em classificar os "NÃOs" do nosso Churn. Interessante. 

Temos esses valores em mãos, sabemos como funciona a matriz de confusão, vamos para a primeira métrica.


O que é a Matriz de confusão? 


A matriz de confusão é uma ferramenta muito utilizada para avaliar modelos de machine learning de classificação. Ela consiste em uma matriz em que as linhas representam os valores reais e as colunas representam os valores preditos. Cada espaço da matriz passa a ser um diagnóstico. A ideia geral é contabilizar a quantidade de vezes que um determinado valor A é classificado como valor B.

Para trabalharmos com um exemplo, vamos pensar em uma lista de possíveis clientes da Alura Voz, na qual você executou um modelo de predição e obteve a seguinte classificação:valores_preditos = [0, 1, 1, 1, 0, 0, 1, 0, 0, 1]COPIAR CÓDIGO


Os valores reais da classificação dessas pessoas são:valores_verdadeiros= [0, 1, 0, 1, 0, 0, 1, 0, 1, 0]COPIAR CÓDIGO


Nele, o valor 0 significa que o(a) cliente possivelmente não irá assinar o plano da Alura Voz e 1 significa que poderá assinar.

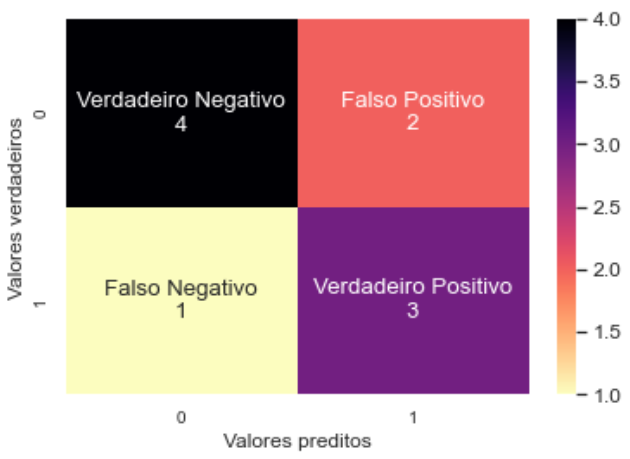
Analisando apenas os valores de valores_preditos e valores_verdadeiros, percebe-se que o modelo errou na classificação de algumas amostras. A matriz de confusão nos mostrará a frequência de classificação para cada classe em nosso modelo da seguinte forma:


Na primeira linha e primeira coluna estão 4 valores verdadeiros negativos, ou seja, o modelo previu a classe como negativa (no nosso exemplo a classe negativa é 0) e isso realmente é verdade. Já na primeira linha e segunda coluna foram classificados 2 valores como 1, porém seu valor real é 0. Como o modelo classificou a classe positiva como sendo negativa, chamamos de falso positivo.

Seguindo para a segunda linha e primeira coluna, temos que o modelo classificou 1 valor como pertencendo à classe 0, porém seu valor real é 1. Logo, o modelo previu a classe negativa, mas isso é falso e chamamos de falso negativo. Por último, na segunda linha e segunda coluna, 3 valores foram classificados como 1, o que realmente é verdade de acordo com o valor real. Logo, foi prevista a classe verdadeira e ela é conhecida como verdadeiro positivo.

Uma observação importante: a matriz de confusão pode se apresentar também na ordem inversa à mostrada aqui, com as linhas sendo os valores preditos pelo modelo e as colunas como os valores reais. Assim, é importante não decorar a ordem, mas realizar a análise feita anteriormente. Dessa forma, você não irá cometer erros.

Para saber como a matriz acima foi criada, você pode acessar o seguinte repositório no GitHub: Gerando matriz de confusão


Implementando um modelo


 Estamos de volta ao Colab e agora vamos começar importando as bibliotecas que iremos utilizar para poder criar nosso modelo.

Começamos importando o pacote Tree da biblioteca SKLearn.from sklearn tree import DecisionTreeClassifier COPIAR CÓDIGO


Vamos rodar e ok. Após importarmos essas funções, importarmos o nosso modelo, precisamos criar o modelo de fato, instanciar esse modelo.

Novamente, criamos uma variável para armazenar este modelo, eu vou criar o dtc =, chamamos a DecisionTreeClassifier, abre e fecha parênteses. Como vocês puderam ver nas aulas anteriores, a árvore de decisão possui diversos parâmetros, parâmetros de crescimento, parâmetros de critério de divisão, temos também a questão do random state, de possibilitar a reprodutibilidade dos resultados.

Aqui, eu escolhi mostrar para você apenas o critério e o random state, porque o que eu rodar aqui você vai conseguir rodar aí e ter o mesmo resultado. Vamos definir o critério, dtc = DecisionTreeClassifier(criterion ='entropy', eu escolhi entropy, vamos como funciona e se adequa ao nosso modelo.

 Lembrando, que quando estamos trabalhando com a árvore de decisão e qualquer outro modelo, o ideal é nós tentarmos e avaliarmos diferentes parâmetros para este modelo e ver aquele que obtém o melhor resultado, a melhor classificação.


Vamos definir vírgula random_state=42, que esse é o nosso estado de aleatoriedade para poder reproduzir os resultados. Rodamos a célula e o modelo foi criado e instanciado e podemos partir para o treino.dtc = DecisionTreeClassifier(criterion='entropy', random_state=42) COPIAR CÓDIGO


dtc.fit e chamamos nossos conjuntos de treino dtc.fit(x_treino, y_treino). O modelo está treinado.

Algo muito interessante que temos, uma função muito interessante que tem na pasta, no pacote da Decision Tree, é a função de verificar a importância da features, a importância dos atributos nesse modelo, na árvore.

 Eu trouxe para mostrar a vocês, claro que depois você pode pesquisar, olhe com calma, mas é muito interessante verificar. dtc.feature_importances_, vamos rodar. Como você ver e relembrar que quanto menor o valor mais homogêneo é, de acordo com a entropia, maior ganho de informação.

Vamos olhar aqui. Temos a primeira variável que é a questão de ser maior de 65 anos ou não e assim por diante. Temos aqui 0.021, tem 0.01, 0.006, dá para ver as diferenças. Têm valores de atributos mais importantes do que outros para classificar os nossos clientes.

Agora vamos aplicar no teste para realmente ver a eficácia do nosso modelo. Vamos criar a variável para armazenar esse resultado: predito_ArvoreDecisao = dtc.predict(x_teste). Pronto, funcionou, modelo testado. Vamos ver os resultados, predito_ArvoreDecisao e aqui está um pequeno trecho do nosso resultado do nosso Churn.


Agora, vamos verificar como escolher o nosso melhor modelo a apresentar para a equipe de vendas.

Como funciona uma arvore de decisão?


Se você está se sentindo doente, mas não faz ideia do que possa ser, quando você vai ao médico são feitas uma série de perguntas (dor de cabeça? febre? tosse?...). Ao final da série de perguntas realizadas pelo médico é emitido um parecer informando qual a causa dos sintomas. Nessa situação apresentada foi seguido o mesmo princípio utilizado em um estimador chamado árvore de decisão.

Árvore de decisão é um dos modelos de previsão mais simples, inspirada na forma que os seres humanos tomam as decisões e tem uma alta interpretabilidade, ou seja, uma compreensão fácil dos passos que foram realizados para conseguir chegar ao resultado final. Ela pode ser utilizada tanto para modelos de regressão, que têm intuito de prever valores numéricos, quanto para modelos de classificação, que têm intuito de prever categorias.

Graficamente, a árvore de decisão pode ser representada de forma que cada uma das decisões tomadas no processo possam ser visualizadas. Seus elementos principais são os nós, ramos e folhas. A estrutura da árvore se inicia com um nó inicial, também chamado de raiz. A partir dela são traçadas ramificações, que geram novos nós e o processo se repete para os nós subsequentes até que chegue a uma folha, que se trata de um nó especial que tem a informação da resposta, sendo ela uma categoria ou um valor previsto.

Cada ramo representa uma tomada de decisão a partir de um valor ou de uma categoria das variáveis explicativas, dividindo o conjunto de dados em nós que apresentam dados com características cada vez mais similares entre si.

Para que fiquem mais compreensíveis esses conceitos, vamos a um exemplo.


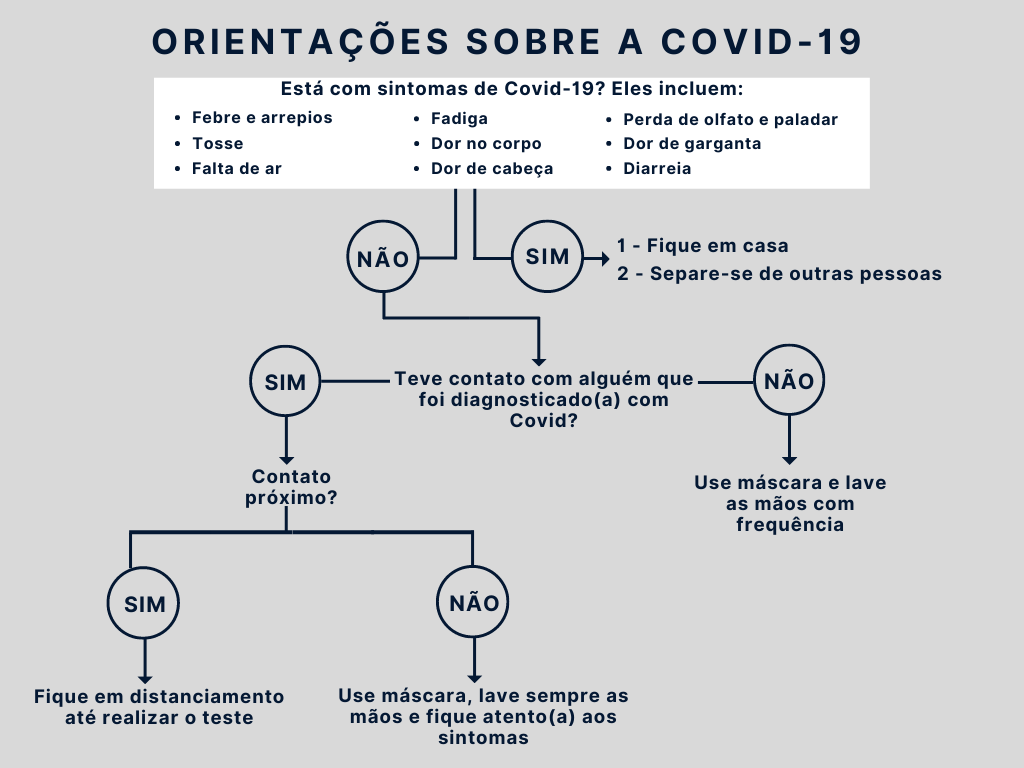
Na imagem de exemplo, temos uma orientação sobre Covid-19 para que as pessoas sejam direcionadas a ficarem isoladas ou não. A raiz ou nó inicial representa a pergunta se a pessoa está com sintomas de Covid-19, como aquelas perguntas realizadas pelo médico indicadas no início desse texto. A pergunta é respondida através dos ramos que partem da raiz, separando as pessoas que possuem sintomas das pessoas que não possuem sintomas.

O nó referente às pessoas que possuem sintomas se trata de um nó folha, com a decisão final de isolamento social. O nó referente às pessoas que não possuem sintomas se trata de um nó interno, que passa por um novo questionamento, criando assim novos ramos e nós. O processo se repete até que se chegue em decisões finais.

Portanto, o esquema se trata de uma Árvore de Decisão, em que é possível detectar todas as escolhas que foram feitas para se chegar às conclusões finais. O algoritmo de computador seguirá esses mesmos princípios, tomando as decisões com base nas variáveis explicativas.
Critério de divisão dos nós

Para conseguir identificar qual o melhor momento em que um nó deve ser dividido em dois ou mais subnós, o algoritmo da árvore de decisão considera alguns critérios. Os dois principais critérios de divisão usados nas árvores de decisão são:
Índice Gini

Este índice informa o grau de heterogeneidade dos dados. O objetivo dele é medir a frequência de um elemento aleatório de um nó ser rotulado de maneira incorreta. Em outros termos, esse índice é capaz de medir a impureza de um nó e ele é determinado por meio do seguinte cálculo:


Onde:pi representa a frequência relativa das classes em cada um dos nós;
k é o número de classes.

Se o índice Gini for igual a 0, isso indica que o nó é puro. No entanto, se o valor dele se aproxima mais do valor 1, o nó é impuro.
Entropia

A ideia básica da entropia é medir a desordem dos dados de um nó por meio da variável classificadora. Assim como o índice de Gini, ela é utilizada para caracterizar a impureza dos dados e pode ser calculada por meio da seguinte fórmula:


Onde:pi representa a proporção de dados no conjunto de dados (S), pertencentes à classe específica i;
c é o número de classes.

Por trás da árvore de decisão


Vamos agora entender melhor e aprender como calcular esses critérios que avaliam o grau de impureza dos nossos atributos para, aí sim, criarmos a nossa própria estrutura de árvore de decisão.


Os principais critérios de divisão dos nós, são os seguintes: temos o índice Gini, o Qui-Quadrado, o Ganho de informação (entropia) e a Redução na variância.

Os mais utilizados e que eu escolhi para trabalharmos com eles, é o índice Gini e o Ganho de informação, a entropia. Eles são os critérios mais utilizados e mais conhecidos, estou dando uma atenção maior a eles. Vamos entender melhor como funciona o índice Gini e esse cálculo de entropia.

Primeiro o Índice Gini. Você já deve estar assustado com a matemática, mas calma que eu vou explicar por partes. Aqui temos a seguinte fórmula: temos o G que é de Gini, igual ao somatório da nossa probabilidade de uma classe ocorrer, vezes ou menos a probabilidade da classe ocorrer. Como assim probabilidade da classe ocorrer? Vamos lá.


Esse Pk é a probabilidade de ocorrência de um dado da classe K. Temos o exemplo da Maria, meses de contrato maior que 50. Meses de contrato é o atributo, ele pode ser maior que 50 ou menor que 50, são os conjuntos resultantes, as classes resultantes desse dado. Nós vamos calcular a probabilidade de ocorrência para cada um desses valores, a probabilidade de ocorrer meses de contrato maior que 50 dividido pela ocorrência de todos os dados, todos os atributos, todas essas características, a ocorrência total dos meses de contrato. E da mesma forma para os meses de contrato menor que 50.

Vamos pegar essa probabilidade e multiplicar pela probabilidade de não ocorrência de um dado da classe K. Nós vamos ter calculado essa probabilidade de qual é a chance da Maria ter meses de contrato maior que 50 entre todas as possibilidades, todas as ocorrências da nossa amostra dos nossos conjuntos de informações.

1 menos isso seria a probabilidade de não ocorrência. O cálculo final vai ser calculado essa probabilidade vezes a probabilidade de não ocorrência de cada uma dessas classes e somar os resultados. Vai pegar o resultado de meses de contrato maior que 50, meses de contrato menor que 50 e vai resultar em um valor.

No caso do índice Gini, a ideia é medir o quão impuro está o dado, o quão heterogêneo ele está. Quando o resultado for próximo de 1, quanto maior o resultado mais heterogêneo o dado está, mais difícil de extrair informações, conseguir dividir este dado em diferentes classes.

 Agora, quanto menor mais homogêneo que seria o ideal. Se aplicarmos esse Índice Gini nos nossos atributos para decidir qual que é o nó raiz, aquele atributo que apresentar o menor Índice Gini vai ser o selecionado para começar a nossa árvore de decisão, é mais homogêneo.

ENTROPIA

Agora, vamos para a entropia, como que a entropia funciona e qual é a ideia de calcular a entropia. A entropia mede a ordem dos dados, de certa forma a entropia e o Índice Gini é semelhante, até por isso que os dois são usados como critérios para verificar a impureza.


Mas a entropia foca no ganho de informação, até outro nome conhecido e bem familiar que você pode encontrar por aí nos materiais.

A entropia vai medir, falamos de desordem, se um dado está muito desordenado, ele está impuro. Vai ser mais difícil conseguir dividir esses dados ou extrair alguma informação dele.

A entropia vai calcular esse ganho de informação, quanto maior a entropia mais desordenado está o dado e quanto menor mais ordenado está, maior ganho de informação. E ele é calculado da seguinte forma: menos o somatório, novamente, da probabilidade da ocorrência daquela classe, vezes o log da probabilidade da ocorrência daquela classe na base dois.

Esse Pk é a mesma coisa do Índice Gini, qual a probabilidade de ocorrer, meses de contrato maior que 50. Vai ser meses de contrato dividido pela quantidade total de ocorrências na nossa amostra. Essa vai ser a probabilidade, aí vai multiplicar pelo log dessa probabilidade na base dois.

Vai ser calculada para maior que 50 meses de contrato e menor que 50. Então, é realizado o somatório desses resultados obtendo a entropia. E da mesma forma que o Índice Gini é feito de forma recursiva, aplicando em todos os atributos e assim a nossa árvore crescendo e se estruturando.

Agora que entendemos como funciona e como se calcula os critérios de decisão, tomada de decisão da divisão dos nós, vamos voltar ao Colab e aplicar de fato o nosso modelo.

Começando um novo projeto