A última métrica que eu apresento a você é o recall. O recall também é conhecido como revocação ou sensibilidade. Preste muita atenção, o recall muitas vezes é confundido com a precisão, porque ele vai medir quão bom o nosso modelo está em classificar os resultados realmente positivos.

Vamos ver a fórmula do recall. Verdadeiros positivos, que são aqueles que foram classificados como sim pelo nosso modelo e que são realmente sim, divididos pelos verdadeiros positivos mais os falsos negativos, "RC = TP/TP + FN". Entendeu a diferença?
Aqui, os falsos negativos não deveriam ser positivos? Por isso que essa métrica é considerada aquela que calcula realmente quais os resultados verdadeiramente positivos. Vamos aplicar no nosso modelo e ver qual o resultado disso.
Novamente vamos chamar a biblioteca metrics e agora o recall_store,
from sklearn.metrics import recall_score
. Funções carregadas no notebook, vamos aplicar o nosso primeiro modelo o KNN:
print(recall_score(y_teste, predito_knn))
, tendo um resultado de 0,8391 ou em porcentagem 83,91%. É um valor muito alto, muito bom e quanto maior quer dizer que melhor está o modelo em classificar esses valores como sim, o nosso Churn sim.
Vamos agora para o modelo Bernoulli de Naive Bayes. A mesma coisa,
Vamos agora para o modelo Bernoulli de Naive Bayes. A mesma coisa,
print(recall_score(y_teste, predito_BNb))
. Já o nosso modelo de Bernoulli foi melhor, ele teve 84,24% de acertos. O nosso modelo está bom em acerta os sins.
Lembrando, que o nosso Churn igual a sim é aquele cliente que realmente saiu da empresa, ele saiu, não faz mais parte, não tem mais contrato ativo, saiu da Alura Voz.
Vamos agora para o modelo final, a árvore de decisão. A mesma coisa dos outros modelos, alterando somente para o predito_ArvoreDecisao.
Lembrando, que o nosso Churn igual a sim é aquele cliente que realmente saiu da empresa, ele saiu, não faz mais parte, não tem mais contrato ativo, saiu da Alura Voz.
Vamos agora para o modelo final, a árvore de decisão. A mesma coisa dos outros modelos, alterando somente para o predito_ArvoreDecisao.
print(recall_score(y_teste, predito_ArvoreDecisao))
, tendo o resultado de 81,96%.
Olha que curioso, cada uma das métricas que apresentei para você mostrou que um modelo era melhor do que o outro. Tivemos a acurácia que trouxe o KNN como melhor modelo, tivemos a precisão que trouxe o modelo de árvore de decisão como melhor. E agora, na recall, na sensibilidade o melhor modelo é o Bernoulli de Naive Bayes.
Olha que curioso, cada uma das métricas que apresentei para você mostrou que um modelo era melhor do que o outro. Tivemos a acurácia que trouxe o KNN como melhor modelo, tivemos a precisão que trouxe o modelo de árvore de decisão como melhor. E agora, na recall, na sensibilidade o melhor modelo é o Bernoulli de Naive Bayes.
F1 Score
O f1 score é uma métrica para identificar se algum dos valores de recall ou precisão estão baixos, uma vez que não é muito interessante ter um modelo com um alto recall e pouca precisão, ou vice versa. Então, caso sua intenção seja obter um valor equilibrado entre o recall e a precisão, a métrica que precisamos maximizar é o f1 score.
Para calcular, devemos utilizar a fórmula:
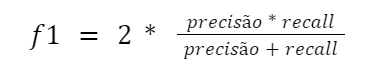
Curva ROC e AUC
Existe ainda uma métrica conhecida como AUC (Area Under the Curve), ou área sob a curva, que pode ser extraída da curva ROC. Essa métrica tem valor máximo de 1 e quanto maior o número mais bem avaliado será o modelo de classificação. Para a construção da curva ROC, precisamos utilizar diferentes pontos de corte para avaliação do modelo de classificação.
É possível criar diferentes matrizes de confusão a partir dos diversos pontos de corte e extrair as métricas de recall (taxa de verdadeiros positivos) e taxa de falsos positivos. Sendo esta última, o valor de falsos positivos dividido pela soma de todos os valores negativos reais. Essas métricas podem ser sumarizadas em uma tabela e serão as coordenadas da curva ROC. Vamos entender como funcionam esses pontos de corte.
Na construção de um modelo de classificação, a predição de uma classe está atrelada a uma probabilidade. Imagine que temos uma variável alvo com duas possibilidades (0 ou 1). Se um modelo classifica uma observação como 1, significa que há uma probabilidade de x% de que aquela observação seja da classe 1.
O ponto de corte é um valor de probabilidade no qual, se a probabilidade de predição for maior que esse valor, atribui-se a observação à classe 1. Se for menor, atribui-se a observação à classe 0. À medida que o ponto de corte varia, os resultados obtidos na classificação se tornam diferentes, fazendo com que o modelo acerte mais de uma classe em troca de errar mais em outra.
Através de um exemplo, ficará evidente como os pontos de corte modificam as métricas da matriz de confusão. Na imagem abaixo estão representados a precisão e o recall. Nela estão definidos 3 pontos de corte em 25%, 50% e 75%, representados pelas setas verticais. Os zeros e uns são os valores reais das classes e a classificação será feita através dos pontos de corte. Os valores à esquerda da seta serão classificados como 0 e os valores à direita serão classificados como 1 pelo modelo.
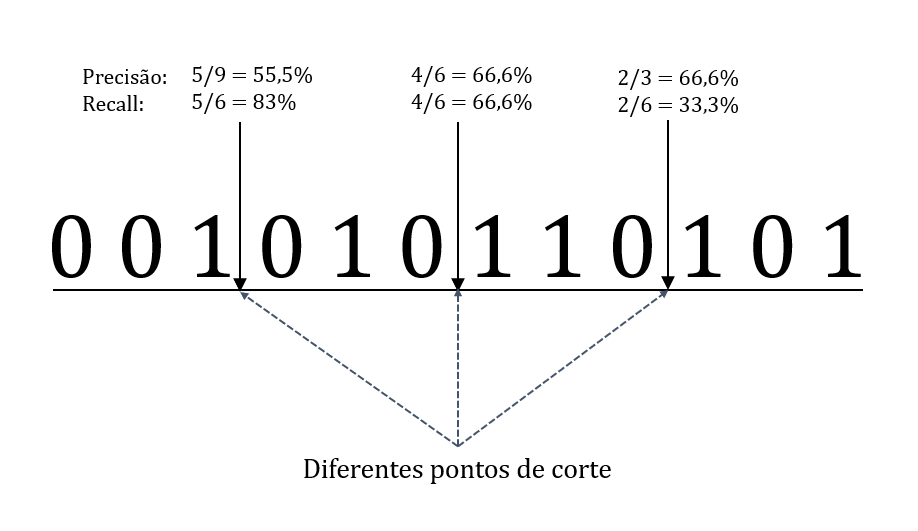
No primeiro ponto de corte temos 3 valores classificados como 0, à esquerda; e 9 valores como 1, à direita. A precisão é dada por 5/(5+4) = 55,5%, mostrando que 5 valores foram classificados corretamente como 1, dentre 9 valores totais classificados como 1. O recall é dado por 5/(5+1) = 83%, indicando que 5 valores foram classificados corretamente como 1, dentre 6 valores reais 1 no conjunto de dados.
No segundo ponto de corte temos 6 valores classificados como 0 à esquerda; e 6 valores classificados como 1, à direita. A precisão é dada por 4/(4+2) = 66,6%, apontando que 4 valores foram classificados corretamente como 1, dentre 6 valores totais classificados como 1. O recall é dado por 4/(4+2) = 66,6%, demonstrando que 4 valores foram classificados corretamente como 1, dentre 6 valores reais 1 no conjunto de dados. O mesmo raciocínio pode ser aplicado para o último ponto de corte, resultando em valores diferentes para as métricas.
Para cada ponto de corte, uma matriz de confusão pode ser criada e as métricas podem ser extraídas em uma tabela, na qual cada linha representa um ponto de corte com suas respectivas métricas. Desta tabela, pode ser construído o gráfico da curva ROC. Esta curva mostra como o classificador se comporta para diferentes valores de pontos de corte, de acordo com a relação de verdadeiros positivos e falsos positivos.
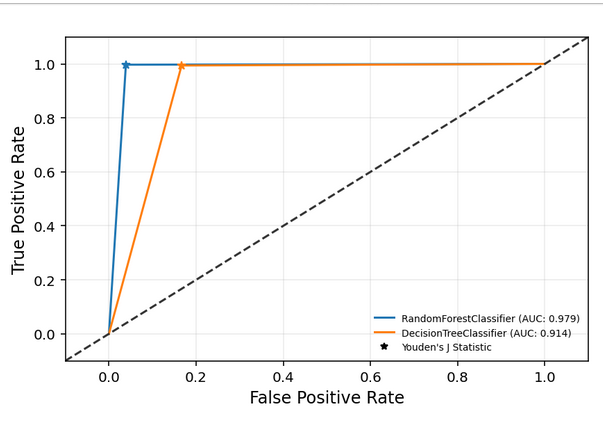
Existe uma linha de referência na diagonal do gráfico que corresponde à uma linha de base e representa o caso no qual o classificador identifica aleatoriamente as classes. Mas como podemos interpretar esse gráfico?
Percebemos que a linha representando o classificador RandomForestClassifier cresce rapidamente até atingir o valor máximo de True Positive Rate (o recall). Isso significa que o modelo atinge 100% de classificação correta dos positivos e permanece até atingir o ponto (1, 1) do gráfico. Esse ponto nos diz que o modelo tem 100% de True Positive Rate e 100% de False Positive Rate (taxa de falso negativos), indicando que ele classifica todas as amostras positivas corretamente e todas as amostras que não são positivas foram incorretamente classificadas.
Então, quando o modelo chega no 100% de True Positive Rate e lá permanece até atingir o 100% do False Positive Rate, ele consegue classificar todas as amostras positivas de forma correta independentemente do threshold adotado. Por outro lado, a linha representando o classificador DecisionTreeClassifier demora mais para chegar no 100% de True Positive Rate. Porém, quando chega no valor máximo, permanece igual à do classificador anterior.
Esse pequeno atraso do DecisionTreeClassifier em relação ao RandomForestClassifier resulta em áreas diferentes, que são as AUCs para cada classificador. O primeiro teve uma AUC de 0.914 e o segundo 0.979. Portanto, esse último é o melhor classificador.


Nenhum comentário:
Postar um comentário